Étude de cas
Le pari
Beaucoup d'entreprises veulent de l'IA générative mais ne peuvent pas envoyer leurs données à une API tierce : santé, juridique, industrie. La démo montre qu'un petit modèle open source suffit pour beaucoup d'usages, sur un serveur ordinaire, sans GPU et sans abonnement facturé à la requête.
L'expérience
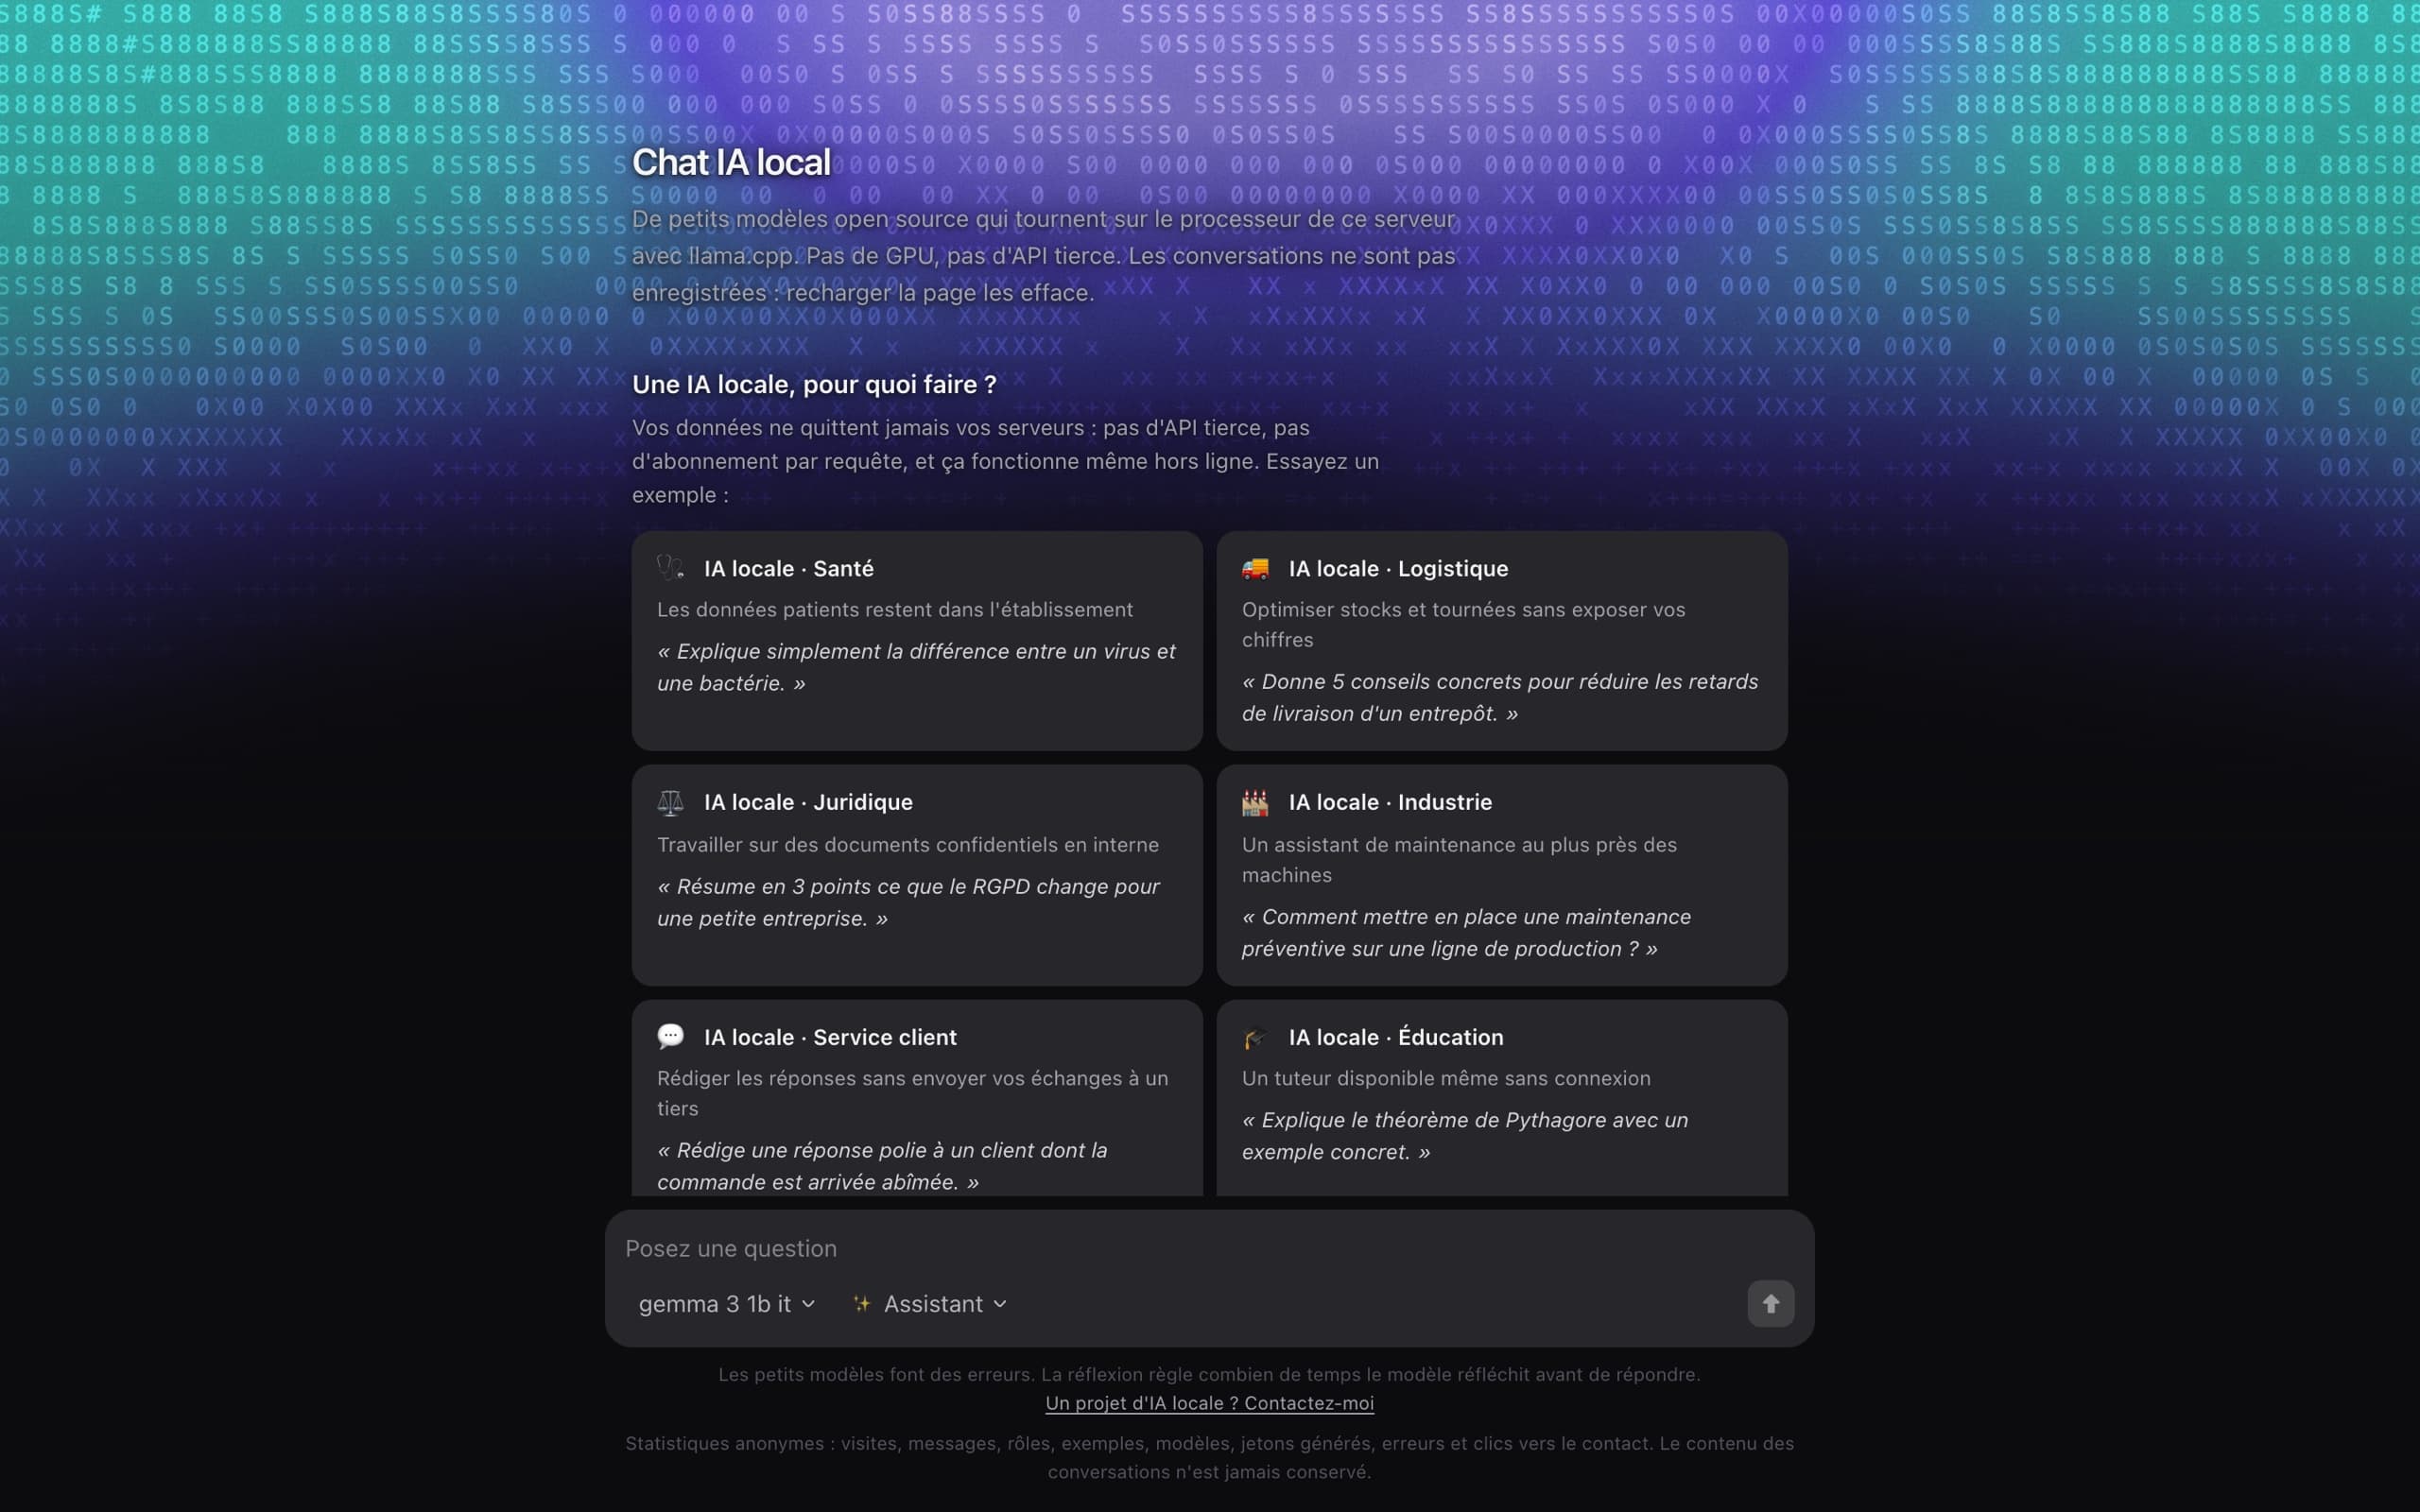
L'accueil part des métiers plutôt que de la technique : six cas d'usage (santé, logistique, juridique, industrie, service client, éducation), chacun avec un exemple prêt à envoyer. Des rôles (assistant, comptable, médecin, plombier) changent le comportement du modèle en un clic.
Les réponses arrivent en streaming, la réflexion du modèle est visible et son niveau réglable.
Sous le capot
Un serveur Node sans framework particulier pilote llama.cpp via node-llama-cpp. Chaque modèle déposé dans un dossier est lu avant d'être proposé : ses capacités s'affichent (réflexion, contexte, mémoire estimée), et un modèle qui dépasserait le budget de mémoire est grisé, avec la raison.
Les modèles se chargent à la demande, les moins récemment utilisés sont déchargés en premier, et une file d'attente, une limite par adresse IP et un plafond mémoire au niveau du système gardent le serveur debout quand plusieurs visiteurs arrivent en même temps.
Confidentialité
Aucune conversation n'est enregistrée : elle vit dans l'onglet du visiteur et n'est envoyée qu'avec chaque requête. Seuls des compteurs anonymes sont tenus (visites, messages, jetons générés, clics vers le contact), et le pied de page dit exactement lesquels.